
Если вы запускаете автономного помощника в Codex и выбираете модель GPT-6.1 Sol, в настройках появился переключатель Ultrafast. Этот режим заставляет нейросеть отвечать почти без пауз между промежуточными шагами. Однако за прирост темпа приходится платить: на тарифе Pro за 500 долларов включённый лимит времени ассистента тает в восемь раз быстрее, а при прямом обращении через интерфейс API вы платите в шесть раз больше базовой ставки.
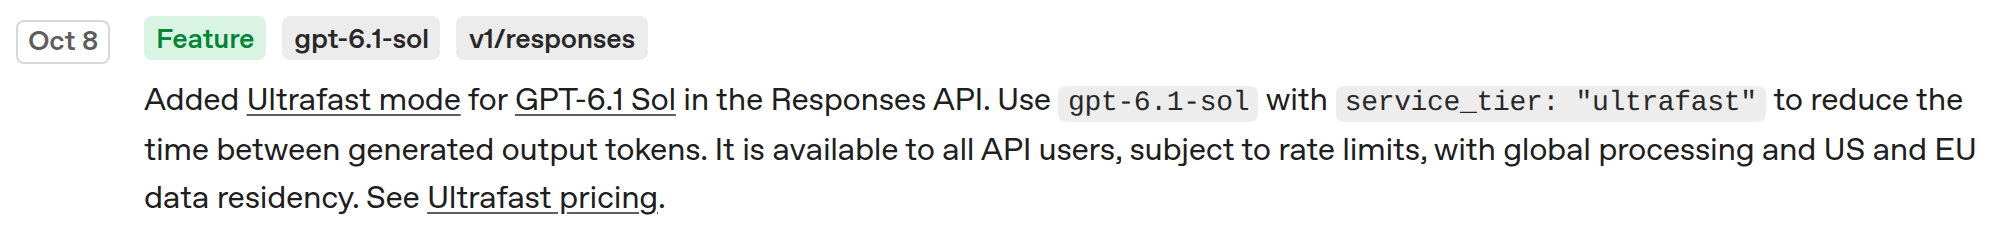
Обновление вышло 8 октября 2026 года, когда OpenAI открыла режим Ultrafast для модели GPT-6.1 Sol одновременно в Responses API и в рабочей среде Codex. Новая настройка призвана решить главную проблему длинных цепочек: когда модель пишет код, запускает тесты и правит ошибки, секунды ожидания между действиями складываются в минуты простоя. Но вместе с ускорением появилась сложная тарифная механика, где скорость и списание лимитов считаются по совершенно разным формулам.
Зачем нужен сверхбыстрый режим и где скрыт подвох
В отличие от простого диалогового окна, программный агент выполняет десятки вспомогательных операций. Он считывает структуру папок, вызывает терминал, сверяет вывод компилятора и делает правки в нескольких файлах подряд. Если нейросеть делает даже короткую задержку перед выдачей очередной порции текста, весь рабочий процесс заметно притормаживает. Режим Ultrafast существенно сокращает паузу перед началом генерации и выдаёт готовые строки непрерывным потоком.
В сообществе разработчиков отметили, что модель способна отдавать токены до восьми раз быстрее по сравнению со стандартным темпом Sol. При этом официальная техническая документация подчёркивает важную деталь для сетевого окружения: если агент постоянно обращается к внешним инструментам, обычные HTTP-запросы могут свести выгоду на нет из-за задержек сети. Чтобы скорость не терялась по пути, создатели рекомендуют держать постоянное WebSocket-соединение.
Почему на тарифе Pro включённые часы сгорают за один вечер
Главная неожиданность ждёт тех, кто использует Codex через подписку ChatGPT Work. На старте переключатель Ultrafast доступен только пользователям топового плана Pro за 500 долларов в месяц, а также подтверждённым корпоративным аккаунтам Enterprise и университетским лицензиям Edu. Пользователи тарифов Plus, базовых Pro за 100 или 200 долларов и планов Business этот режим не увидят вовсе. В справочном центре прямо указано, что включить его на младших планах невозможно даже при покупке дополнительных кредитов.
Но ещё важнее то, как именно списываются ресурсы на старшем тарифе. Подписка за 500 долларов включает ежемесячный пакет времени для работы агентов. Когда вы переводите GPT-6.1 Sol в режим Ultrafast, встроенный лимит начинает расходоваться со скоростью 8× относительно базового режима той же модели. Если же включённый пакет заканчивается и в дело вступают платные кредиты воркспейса, они списываются уже по ставке 6× от стандартной цены.
В итоге инженер, который оставляет автономного помощника разбирать крупный проект на ночь на максимальной скорости, рискует исчерпать месячную норму всего за пару активных сессий. При этом внешне интерфейс не предупреждает о лавинообразном расходе: кажется, что агент просто работает бодрее обычного.
Если вы внедряете нейросети в повседневную разработку и хотите вовремя замечать подводные камни в тарифах и лимитах, загляните в наш Telegram-канал Ковчег: там мы разбираем свежие обновления автоматизации без лишнего шума.
Как считается стоимость запросов в Responses API
Если вы подключаете модель напрямую через программный интерфейс API, условия меняются. Здесь режим доступен всем зарегистрированным пользователям без привязки к дорогой подписке, но для него выделены отдельные ограничения по количеству токенов в минуту: от одного миллиона для начального уровня Build до сорока миллионов на уровне Grow. Кроме того, Sol Ultrafast сразу поддерживает хранение и обработку данных в регионах США и Европы.
В API множитель остаётся единым: Ultrafast стоит ровно в шесть раз дороже стандартного режима Sol. Для коротких запросов с контекстом до 272 тысяч токенов миллион входных токенов обойдётся в 12 долларов вместо обычных двух, а миллион выходных — в 60 долларов вместо десяти. Запись в кэш стоит 15 долларов против 2,50, а чтение из кэша оценено в 60 центов вместо десяти.
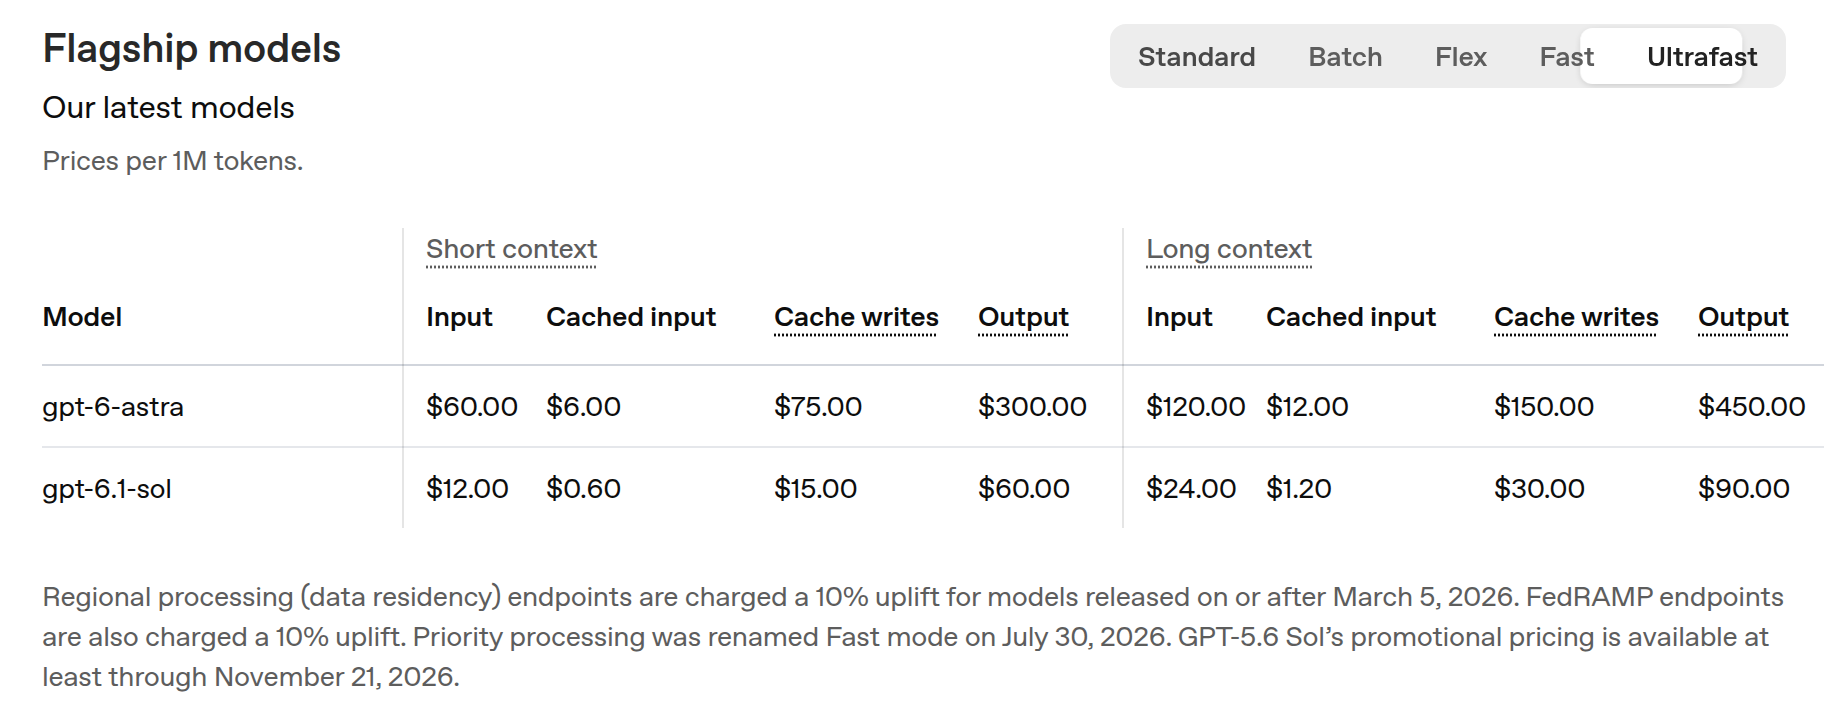
Любопытно сравнить эти цифры со старшей моделью GPT-6 Astra. Обычная Astra в стандартном режиме стоит 10 долларов за миллион входных токенов и 50 за выходные. Получается, что разогнанный Sol Ultrafast в API всего на двадцать процентов дороже базовой Astra, хотя по сравнению со своим стандартным режимом подскакивает сразу вшестеро. Однако сама Astra в режиме Ultrafast улетает в стратосферу: 60 долларов за вход и 300 за миллион токенов на выходе.
Отдельная ловушка связана с длинным контекстом. Как только объём входящих данных превышает порог в 272 тысячи токенов, повышающий коэффициент применяется ко всему запросу целиком, а не только к остатку сверх лимита. В результате для длинных диалогов миллион входных токенов Ultrafast Sol стоит уже 24 доллара, а выходных — 90 долларов.
Когда имеет смысл включать максимальную скорость
Выбирать сверхбыстрый режим стоит осознанно, соотнося цену с реальной задачей. Если вы сидите перед экраном, отлаживаете конкретную функцию и ждёте результат каждого шага, экономия нескольких минут живого времени вполне оправдывает повышенный расход. В интерактивной сессии высокая скорость помогает не терять фокус и быстро направлять ассистента в нужное русло.
Если же вы запускаете фоновую рутину, пакетную обработку файлов или масштабный рефакторинг, за которым никто не следит в реальном времени, включать Ultrafast нет никакого практического смысла. Агент выполнит ту же самую работу на стандартной скорости Sol без переплаты в шесть или восемь раз, сохранив баланс подписки и избавив от неприятных сюрпризов в счетах за API.