Mellum — это открытая языковая модель от компании JetBrains, которую создали для роли автономного помощника внутри программных проектов: она способна самостоятельно находить причину поломки, вносить изменения в файлы и проверять свои действия запуском тестов. В вышедшей 8 октября 2026 года версии Mellum 2.1 разработчики заявили о резком скачке качества решения реальных инженерных задач. Если прошлая версия в тестах на починку репозиториев практически не могла справиться с полным циклом работы, то обновленный вариант решает почти половину предложенных проблем. Однако за громкими цифрами скрываются важные технические оговорки, о которых стоит знать до развертывания модели на своем сервере.
Зачем разработчикам понадобилась отдельная компактная модель
Автономные системы для работы с кодом чаще всего ассоциируются с огромными облачными моделями. Но у такого подхода есть два барьера: цена и конфиденциальность. Если поручить внешней нейросети непрерывно следить за проектом, слать запросы на каждый коммит и читать документацию, счет за сторонний сервис быстро станет ощутимым. Главное — коммерческий исходный код многие компании принципиально не передают во внешние облака.
Для таких задач удобнее держать небольшую модель на своем сервере или рабочей станции. Mellum создавали именно под эту роль: у нее архитектура с разделением экспертов общим объемом 12 миллиардов параметров, но при генерации ответа активны лишь 2,5 миллиарда. Это дает скорость компактной модели при емкости более крупной нейросети. Она не рассуждает о посторонних вещах, а решает практические задачи разработчика.
Как модель научили не просто советовать, а работать руками
Главная перемена в версии 2.1 произошла не в структуре нейросети, а в способе ее подготовки. Саму архитектуру создатели вообще не меняли со времен июньского релиза второй версии. Весь прорыв обеспечило интенсивное обучение с подкреплением, которое шло все минувшее лето. Модель не просто учили на готовых примерах хорошего кода, ее буквально поместили внутрь изолированных сред с реальными репозиториями, выдав терминал и базовые инструменты для навигации по файлам.
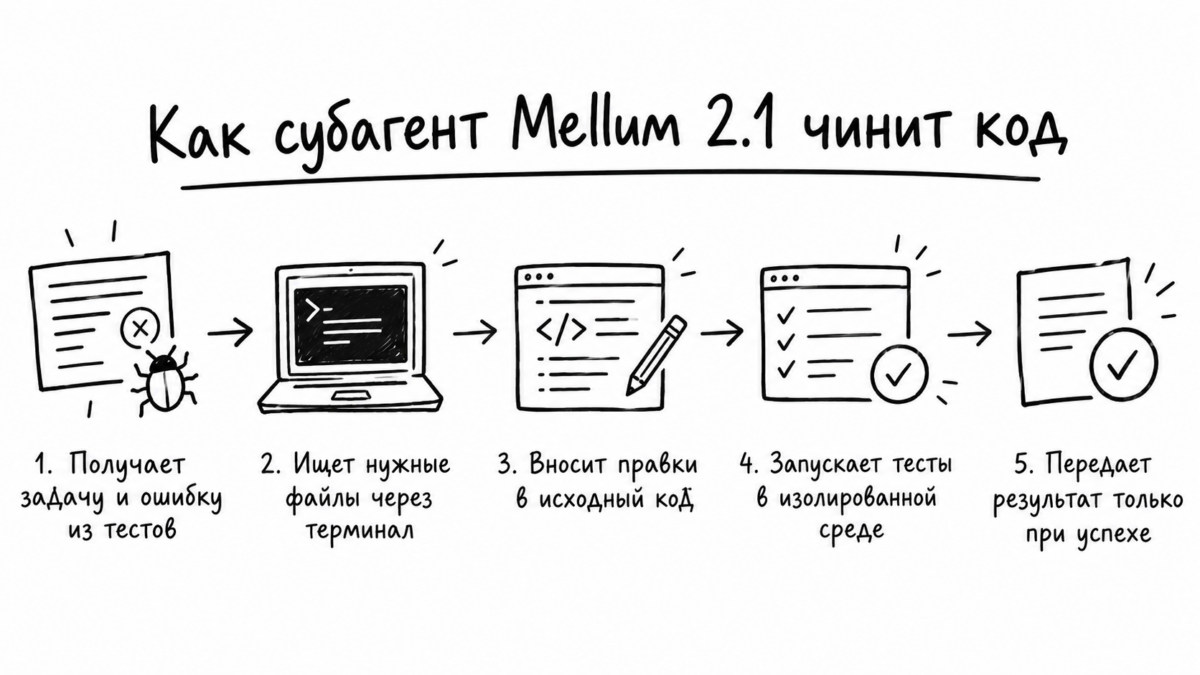
Схема тренировки была прямой: модель получала отчет о сбое, искала проблемное место, правила файлы и перезапускала проверку. При зеленых тестах алгоритм получал награду, а тупиковые ветки отбрасывались. Из открытых наборов задач убрали нерешаемые кейсы и тесты с невнятными ответами, прогнав миллионы циклов в тысячах изолированных песочниц.
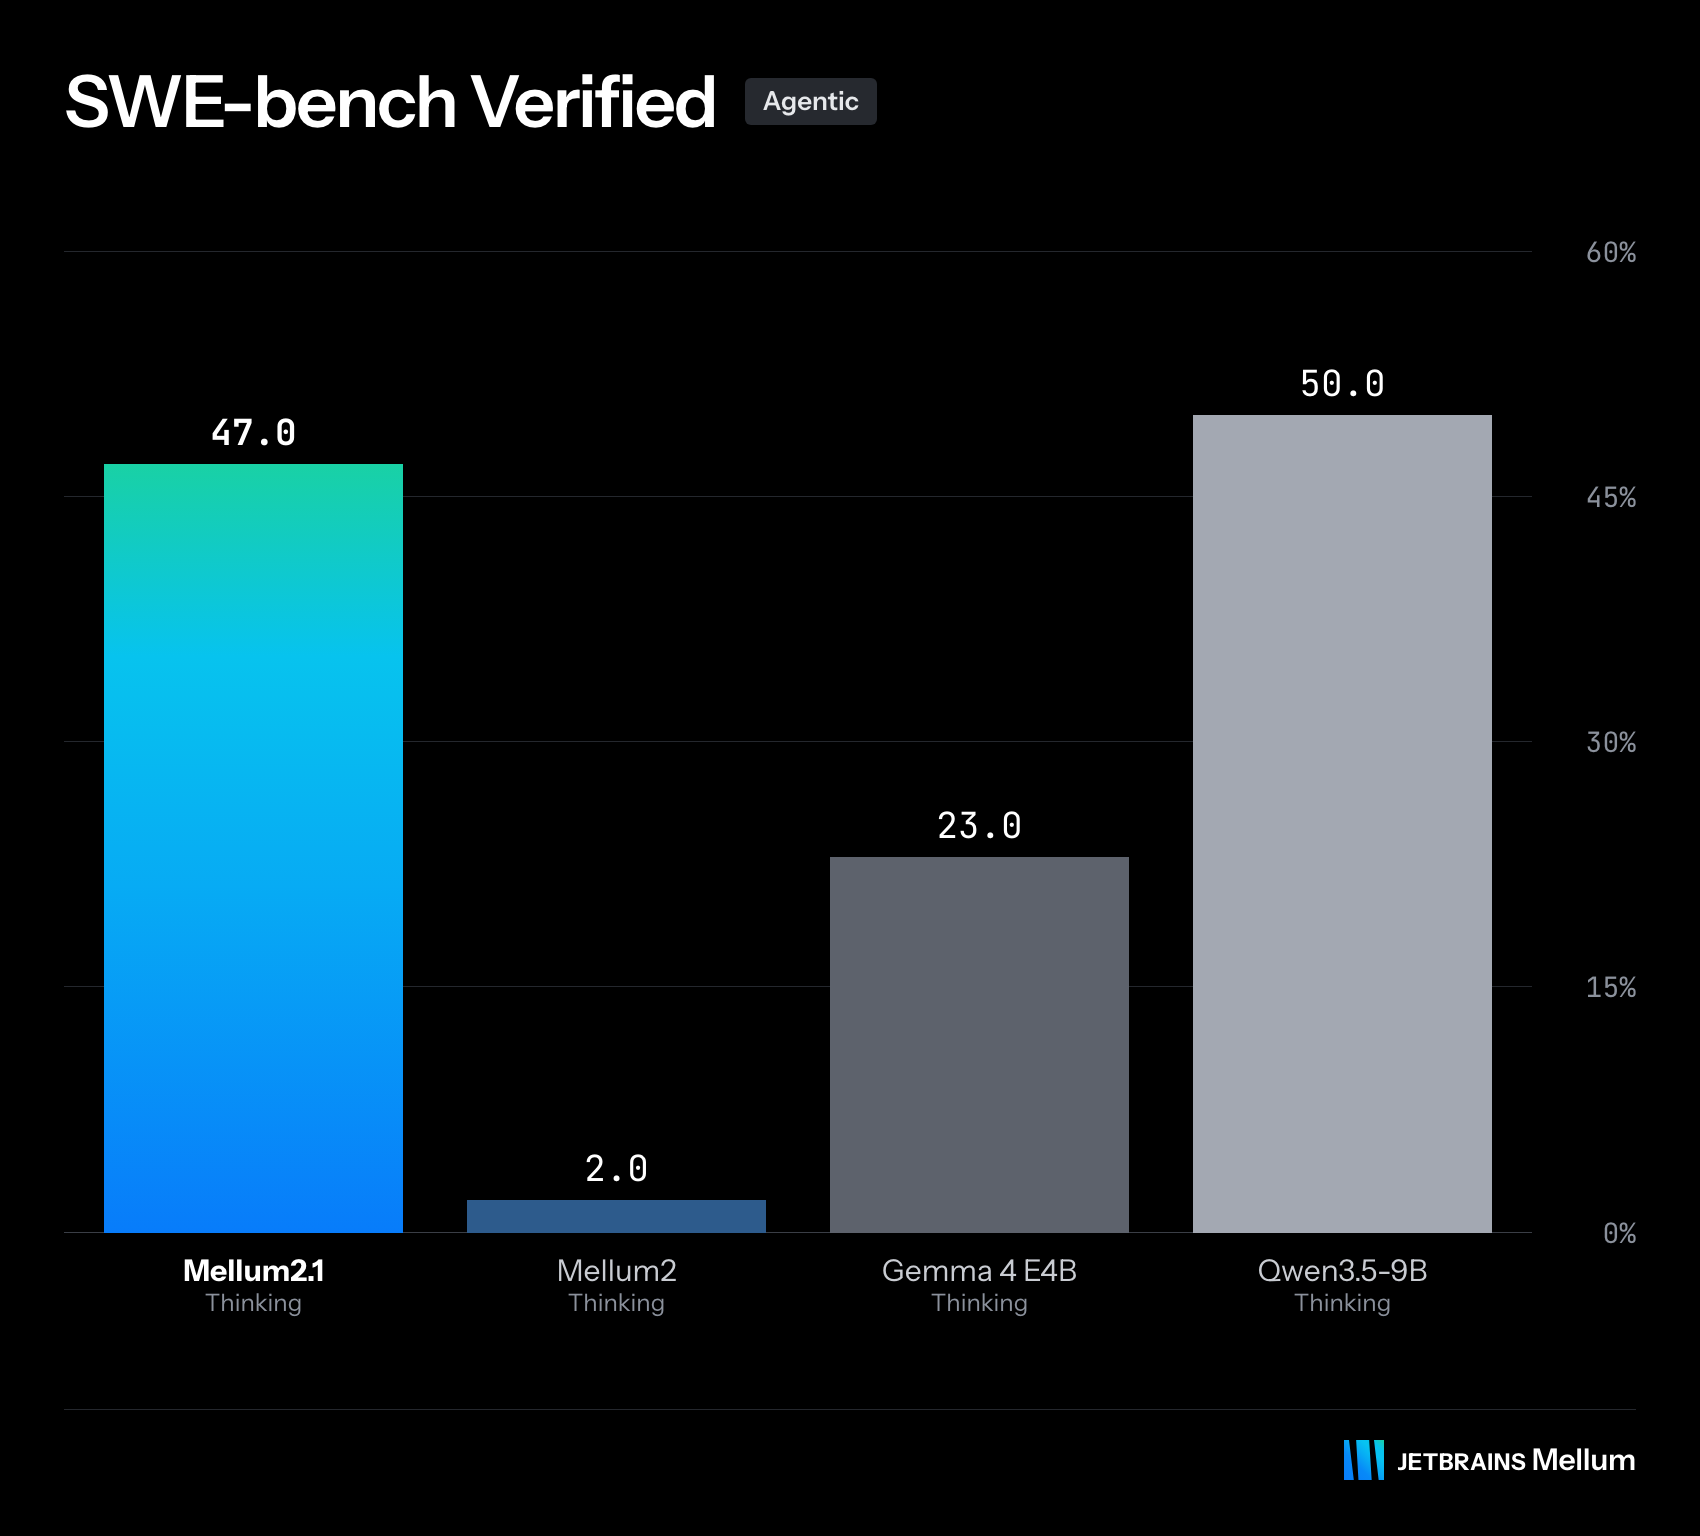
В итоге на популярном тесте SWE-bench Verified, где моделям дают реальные задачи из репозиториев GitHub, показатель Mellum 2.1 взлетел с почти нулевых 2,0 процента у прежней версии до внушительных 47,0 процента. Модель научилась удерживать в памяти контекст задачи, не сбиваться при первых сообщениях об ошибках в консоли и методично доводить исправление до работающего состояния.
Свежие разборы открытых нейросетей, агентских инструментов и практических сценариев автоматизации регулярно выходят в Telegram-канале Ковчег.
Где начинаются честные ограничения и почему Qwen пока впереди
Впечатляющий скачок в бенчмарках легко принять за окончательную победу, но цифры требуют трезвого взгляда. Прежде всего, все опубликованные сведения — это внутренний отчет компании JetBrains, полученный на собственном испытательном стенде. Независимого подтверждения от сторонних разработчиков на реальных коммерческих проектах пока нет.
В сравнительной таблице создателей соседняя открытая модель Qwen3.5-9B все еще удерживает лидерство на сложных тестах. На SWE-bench Verified у нее 50,0 процента против 47,0 у новинки. На строгом тесте SWE-bench Pro разрыв заметнее: 38,0 процента против 28,0 у Mellum 2.1. В консольном Terminal-Bench конкурент тоже впереди — 21,7 против 17,4 процента.
Кроме того, глубокая настройка на правку репозиториев задела смежные навыки. На синтетическом тесте кода WorkBench результат даже немного снизился: 44,6 балла против 45,1 у прошлой версии. Это понятная плата за специализацию: за рамками типового цикла поиска ошибок модель может вести себя менее предсказуемо. К тому же Mellum 2.1 работает в режиме рассуждений: перед ответом она подробно формулирует мысли, что способно быстро расходовать лимит контекста.
Что нужно для запуска на собственном оборудовании
Для локального развертывания новинки не потребуется вычислительный кластер из десятков профессиональных ускорителей. Благодаря тому, что в каждый момент времени активно лишь около двух с половиной миллиардов параметров, модель вполне комфортно чувствует себя на одной современной видеокарте с объемом видеопамяти от 16 до 24 гигабайт. Она поддерживает контекстное окно размером до 131 тысячи токенов, чего с запасом хватает для загрузки средних программных модулей и логов сборки.
Официальный способ запуска исходных весов — движок vLLM. В анонсе разработчики указали, что сжатые версии GGUF для Ollama появятся позже. Однако в профиле компании на Hugging Face уже опубликован репозиторий с пятью готовыми квантованиями, включая четырехбитный вариант весом около восьми гигабайт, подходящий для обычного ноутбука.
При этом обещанный механизм спекулятивного декодирования, способный ускорить генерацию в полтора раза за счет предсказания нескольких токенов сразу, в текущий общедоступный релиз весов пока не включен. На практике это означает, что модель уже готова к работе и тестированию в роли локального помощника, но максимальную скорость покажет чуть позже, когда создатели выложат дополнительные модули ускорения.