
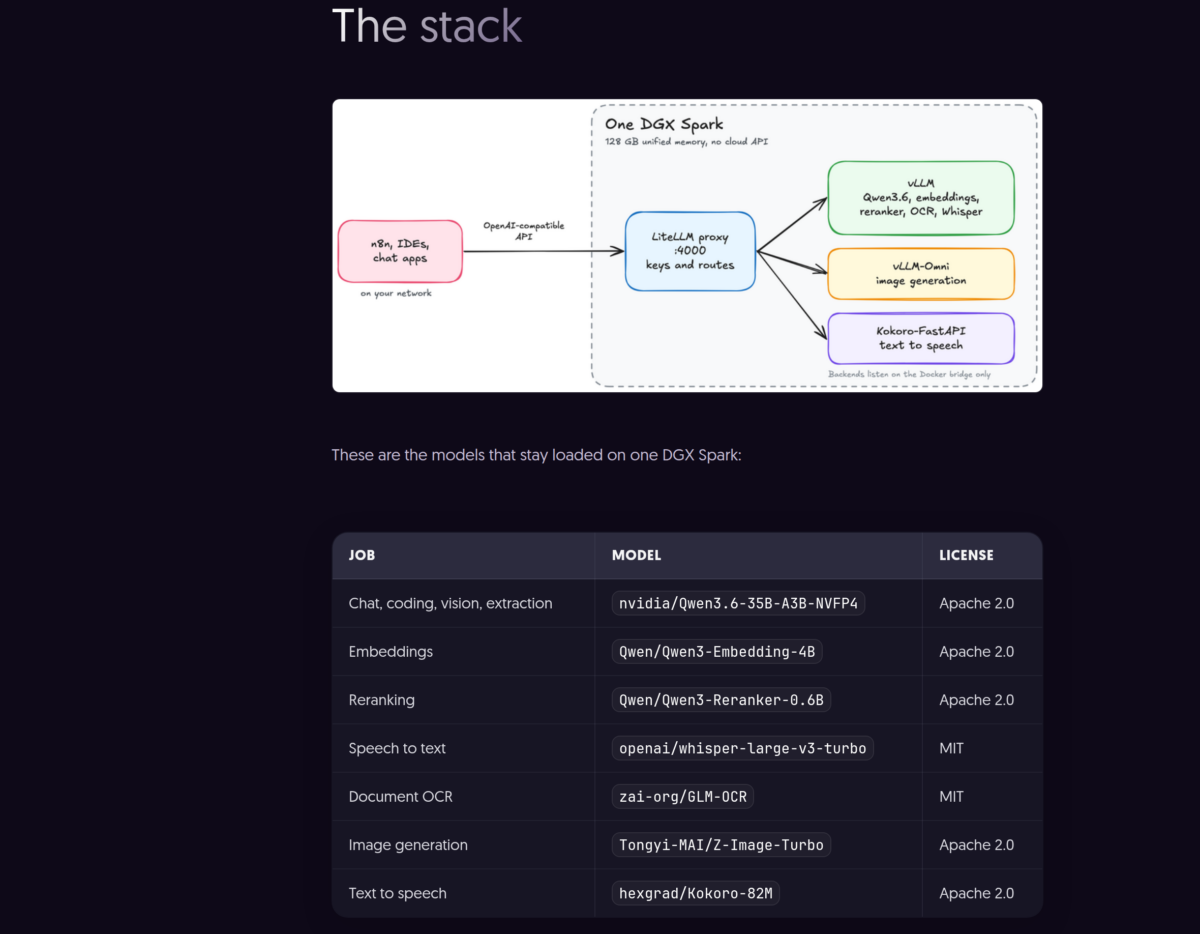
Если поставить в офисе компактный сервер NVIDIA DGX Spark на 128 гигабайт и подключить его к конструктору автоматизации n8n, в память одновременно помещаются сразу семь локальных нейросетей: для ответов сотрудникам, разбора счетов, поиска по документам, работы с голосом и рисования иллюстраций. Однако разбор в официальном блоге n8n от 19 октября 2026 года показал неприятную ловушку: памяти коробке хватает, но видеокарта у всех задач одна. Как только кто-то запускает генерацию картинки на настройках по умолчанию, скорость текстовых ответов остальной команде падает примерно на две трети, а стандартный узел OpenAI в n8n с версии 1.3 стучится не в тот протокол.
Почему памяти хватает всем моделям, а очередь упирается в одну видеокарту
Знакомство с локальными моделями в n8n часто начинают со стартового набора с Ollama, но документация прямо помечает его как песочницу для одного человека на ноутбуке. Для работы команды в тесте от 13 октября 2026 года взяли серверный движок vLLM 0.30.0, который объединяет запросы нескольких сотрудников в один проход по весам модели, и запустили его на рабочей станции DGX Spark. По паспорту NVIDIA внутри стоит чип GB10 Grace Blackwell и 128 гигабайт общей памяти LPDDR5x с полосой 273 гигабайта в секунду. На странице модели есть и партнёрская версия на 64 гигабайта, но этот набор в неё не влезет: Linux видел 121 гигабайт, семь открытых моделей (Apache 2.0 и MIT) заняли 108 гигабайт, оставив свободными около 13 гигабайт.
Без генерации картинок текстовая модель Qwen3.6-35B-A3B-NVFP4 выдаёт первый кусочек слова — токен — по медиане за 0,11–0,29 секунды. Дальше один человек получает 120 токенов в секунду, четверо — по 68, восемь — по 47. В строке общей пропускной способности у одного пользователя стоит 87 токенов в секунду вместо 120: один из пяти запросов просел до 43 токенов в секунду и вместе с ожиданием старта потянул среднее вниз. Авторы подчёркивают, что это цифры одного прогона, а чип в текущей сборке считает четырёхбитные веса в 16 битах через Marlin.

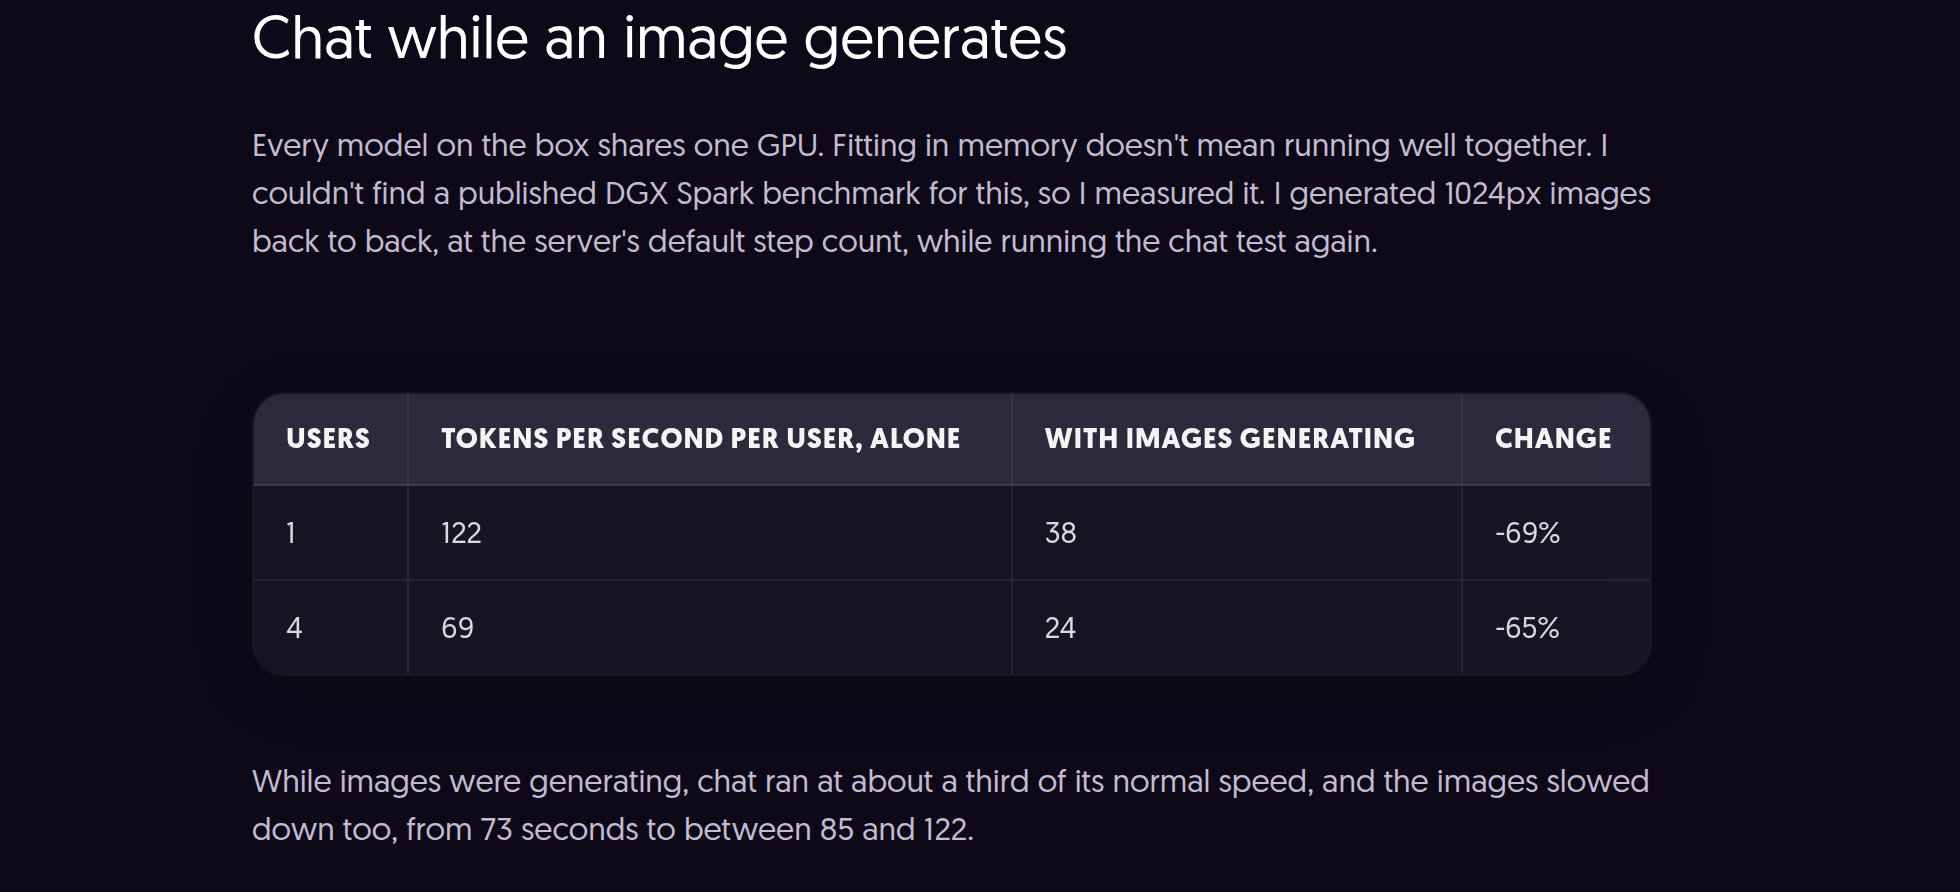
Как только параллельно с вопросами запускают генерацию картинок 1024×1024 пикселя, темп текстовых ответов одному сотруднику падает со 122 до 38 токенов в секунду (−69%), а четырём — с 69 до 24 (−65%). Сами иллюстрации при этом замедляются с 73 до 85–122 секунд.

Какие две настройки съедают минуты и мешают подключить n8n
Причина провала — настройки контейнера vLLM-Omni по умолчанию. Модель Tongyi-MAI/Z-Image-Turbo рассчитана на 8 шагов прорисовки и выдаёт картинку по медиане за 12,2 секунды. Но сервер по умолчанию гоняет около 48 шагов по полторы секунды, занимая видеокарту на 72 секунды ради одного изображения. В штатном узле OpenAI внутри n8n нет поля для числа шагов, поэтому num_inference_steps: 8 передают через дополнительные параметры тела запроса (extra_body). Для маленькой команды редкие иллюстрации лучше ставить в очередь после рабочего дня, а при ежедневном потоке графики — выносить медиа на второй DGX Spark.
Вторая заминка возникает при подключении n8n к локальному шлюзу LiteLLM на порту 4000. В исходном коде узла OpenAI Chat Model начиная с версии 1.3 тумблер Use Responses API включён по умолчанию (default: true), хотя справка n8n описывает его так, будто без переключения остаётся классический Chat Completions. Поскольку локальный стек отдаёт ответы через Chat Completions, этот переключатель нужно выключить вручную.
Практические разборы того, как связывать сценарии автоматизации и локальные модели без лишних потерь времени, регулярно выходят в нашем Telegram-канале.
Что происходит на разборе счёта и голоса без ручных правок
В готовом шаблоне сценария 21011 для счетов модуль GLM-OCR за 1,8 секунды считывает текст с картинки PNG или JPEG (PDF нужно предварительно перевести в изображение), а затем Qwen3.6 извлекает поставщика, номер, дату, сумму и валюту. С включённым режимом рассуждений модель думала 12,1 секунды и потратила 1616 токенов, из которых 1538 ушли на внутренние размышления. Когда в HTTP-запросе передали enable_thinking: false, те же пять полей вернулись за 0,59 секунды и 76 токенов. Но проверка человеком всё равно нужна: GLM-OCR верно прочитал сумму и строки, однако пропустил один ноль в налоговом номере VAT ID. А модель Whisper, расшифровав тридцать секунд речи за 0,58 секунды, из-за тишины в конце записи сама дописала вежливое «спасибо» (Thank you.).

Где заканчивается изоляция и какую версию прокси брать
Фраза о том, что ни один байт не покидает сеть, касается только самих моделей после скачивания 220 гигабайт весов и включения HF_HUB_OFFLINE=1; сам n8n, вебхуки и почта продолжают работать с сетью по вашим настройкам. Для прослойки LiteLLM в конфиге нужен параметр drop_params: true, чтобы запросы картинок не падали с ошибкой 400, а версию контейнера авторы советуют фиксировать по контрольной сумме не ниже 1.84.0 (в тесте стояла 1.99.1). Выпуск 1.84.0 закрыл два обхода проверки подлинности, включая уязвимость заголовка Host, а в марте 2026 года в PyPI на сорок минут появлялись заражённые версии 1.82.7 и 1.82.8, попавшие в отчёт об инциденте. Коробка на 128 гигабайт действительно тянет полный набор моделей в памяти, если развести по времени графику и живые ответы, отключить лишние размышления на бланках и перепроверять номера документов.