
Google выпустила Gemini 3.8 Live — голосовые модели, которые умеют одновременно разговаривать с вами и крутить внешние инструменты. Раньше ассистент после любой сложной просьбы заставлял слушать мёртвую тишину в трубке. Теперь модель продолжает живую беседу, пока на сервере бронируется рейс, проверяется календарь или отправляется письмо.
Для разработчиков это меняет саму механику диалога. Больше не нужно гадать, зависла программа или оборвалась связь. Вы общаетесь с ассистентом как с коллегой за столом: задаёте вопросы, меняете тему, а готовый ответ мягко вплетается в разговор.
Почему голосовые помощники раньше бросали трубку
Классические голосовые ассистенты работали строго по очереди. Вы произносите команду, система отправляет запрос и ждёт ответ от внешней функции. В этот момент звуковой поток замирал. Пока сервер искал билеты в базе данных, в трубке стояла неловкая пауза.

Человек воспринимает молчание дольше двух секунд как сбой. Мы начинаем переспрашивать «вы тут?», нервничать и сбрасывать звонок. Разработчикам приходилось включать музыку на удержании или вставлять шаблонное «пожалуйста, подождите». Живой беседы не получалось.
Голосовой помощник больше не зависает в тишине: пока система ищет билеты через внешний сервис, модель продолжает спокойно общаться и отвечать на попутные вопросы.
Проблема крылась в старой блокирующей архитектуре. Модель не умела одновременно генерировать речь и ждать ответ от стороннего сервиса. Любое обращение к базе данных замораживало эфир. Теперь эту преграду убрали на уровне протокола.
Как устроен разговор без пауз в эфире
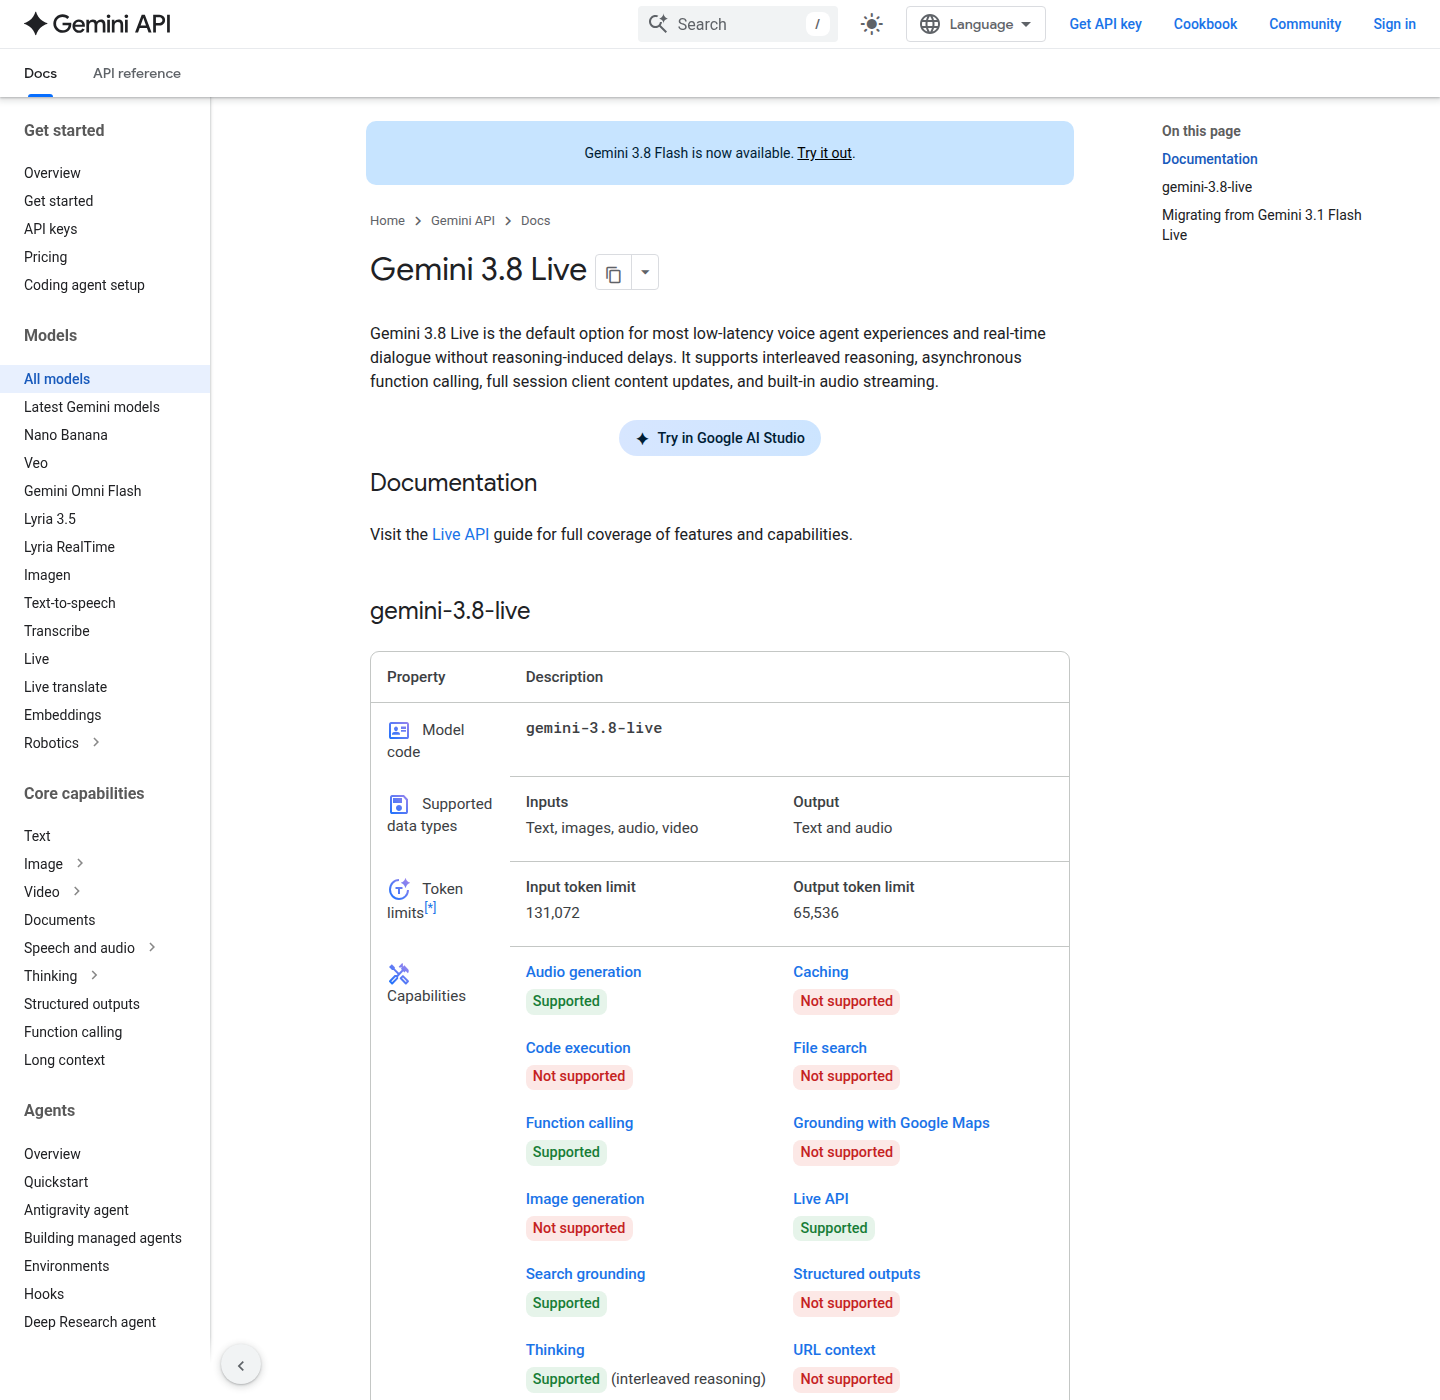
В основу системы положили асинхронный протокол. Когда ассистент вызывает внешнюю функцию, генерация речи не останавливается. Запрос уходит в фон, а разговор продолжается. Этот фоновый режим включён по умолчанию в документации Gemini 3.8 Live.

Вот наглядный пример: вы просите забронировать билет на самолёт в Нью-Йорк на четырнадцать часов. Приложение запускает бронь, а модель вслух говорит: «Принято, оформляю перелёт». Вы тут же спрашиваете: «А сколько там сейчас времени?». Модель сразу отвечает про время в городе. Когда бронирование готово, ассистент спокойно добавляет: «Кстати, билет подтверждён, номер брони отправила на почту».
Для фоновых инструментов добавили три режима отдачи данных по правилам асинхронных вызовов в Google Cloud. Ассистент может сообщить результат при первой паузе в речи, молча сохранить данные в контексте или сразу прервать фразу при срочном событии.

Свежие разборы голосовых механик и практических сценариев мы выкладываем в телеграм-канале Ковчег и в сообществе MAX, а пошагово собирать надёжные рабочие связки учим на курсе обучение по Make.
Две модели для простых реплик и глубоких задач
Линейку разделили на две модели под разные задачи, о чём сказано в официальном анонсе линейки. Первая модель — лёгкая и быстрая. Она создана для естественного общения, клиентской поддержки и быстрых ответов с минимальной задержкой. В ней при желании можно включить и старый блокирующий режим.

Вторая модель создана для сложных многошаговых рассуждений и называется Extended Thinking. В ней блокирующий режим запрещён: при попытке его включить сервис выдаст ошибку. Модель сама ведёт цепочку рассуждений и параллельно запускает инструменты.
В режиме расширенного рассуждения модель предупреждает вслух о каждом шаге и сама заполняет паузы, пока в глубине идут сложные вычисления.
Не путайте эту голосовую линейку с текстовой моделью Flash начала сентября. Здесь звук идёт напрямую в нейросеть без перевода в буквы и обратно. Это сохраняет естественные интонации, эмоции и живой темп разговора.
Что нужно знать про новые сигналы и цены
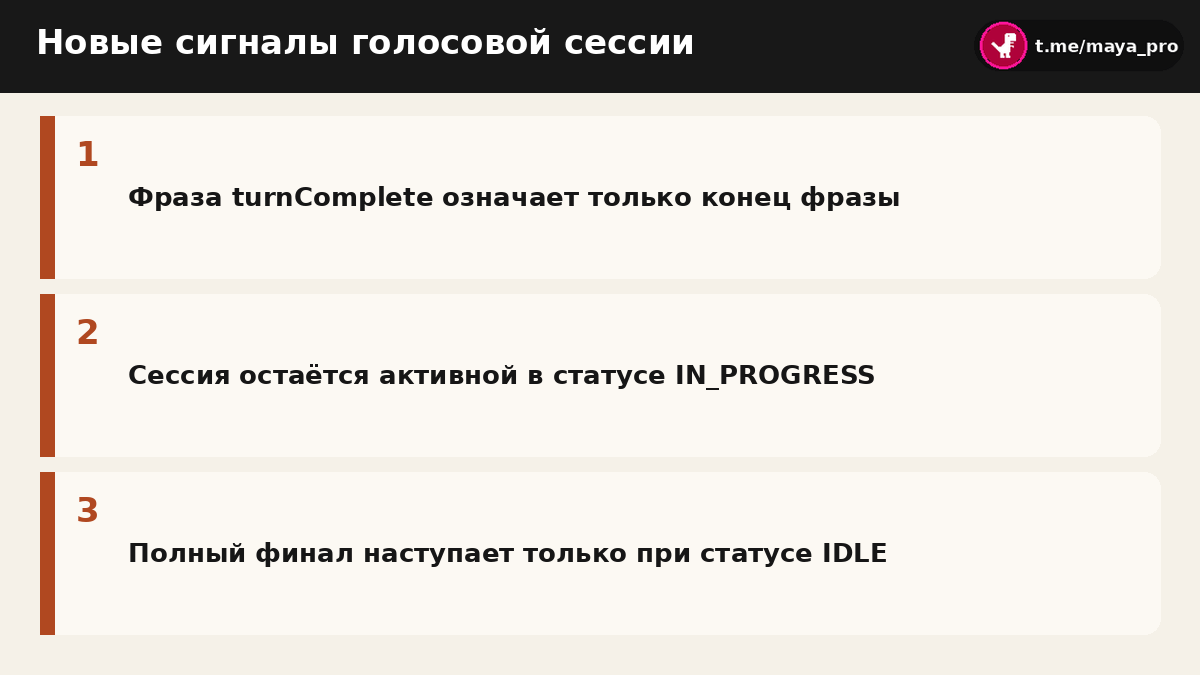
В коде придётся перестроить логику ожидания ответа. Раньше признаком завершения работы служил сигнал конца фразы. Теперь флаг окончания реплики означает лишь то, что помощник договорил конкретную фразу. Сессия остаётся активной, пока общий статус взаимодействия не перейдёт в состояние покоя.

Сигнал завершения реплики больше не означает конец работы: сессия остаётся живой и ждёт результаты фоновых инструментов.
Пока статус остаётся в процессе работы, модель думает или ждёт ответа от функции. Если закрыть поток раньше, задача оборвётся. Все тонкости состояний описаны в руководстве по рассуждениям Live API.
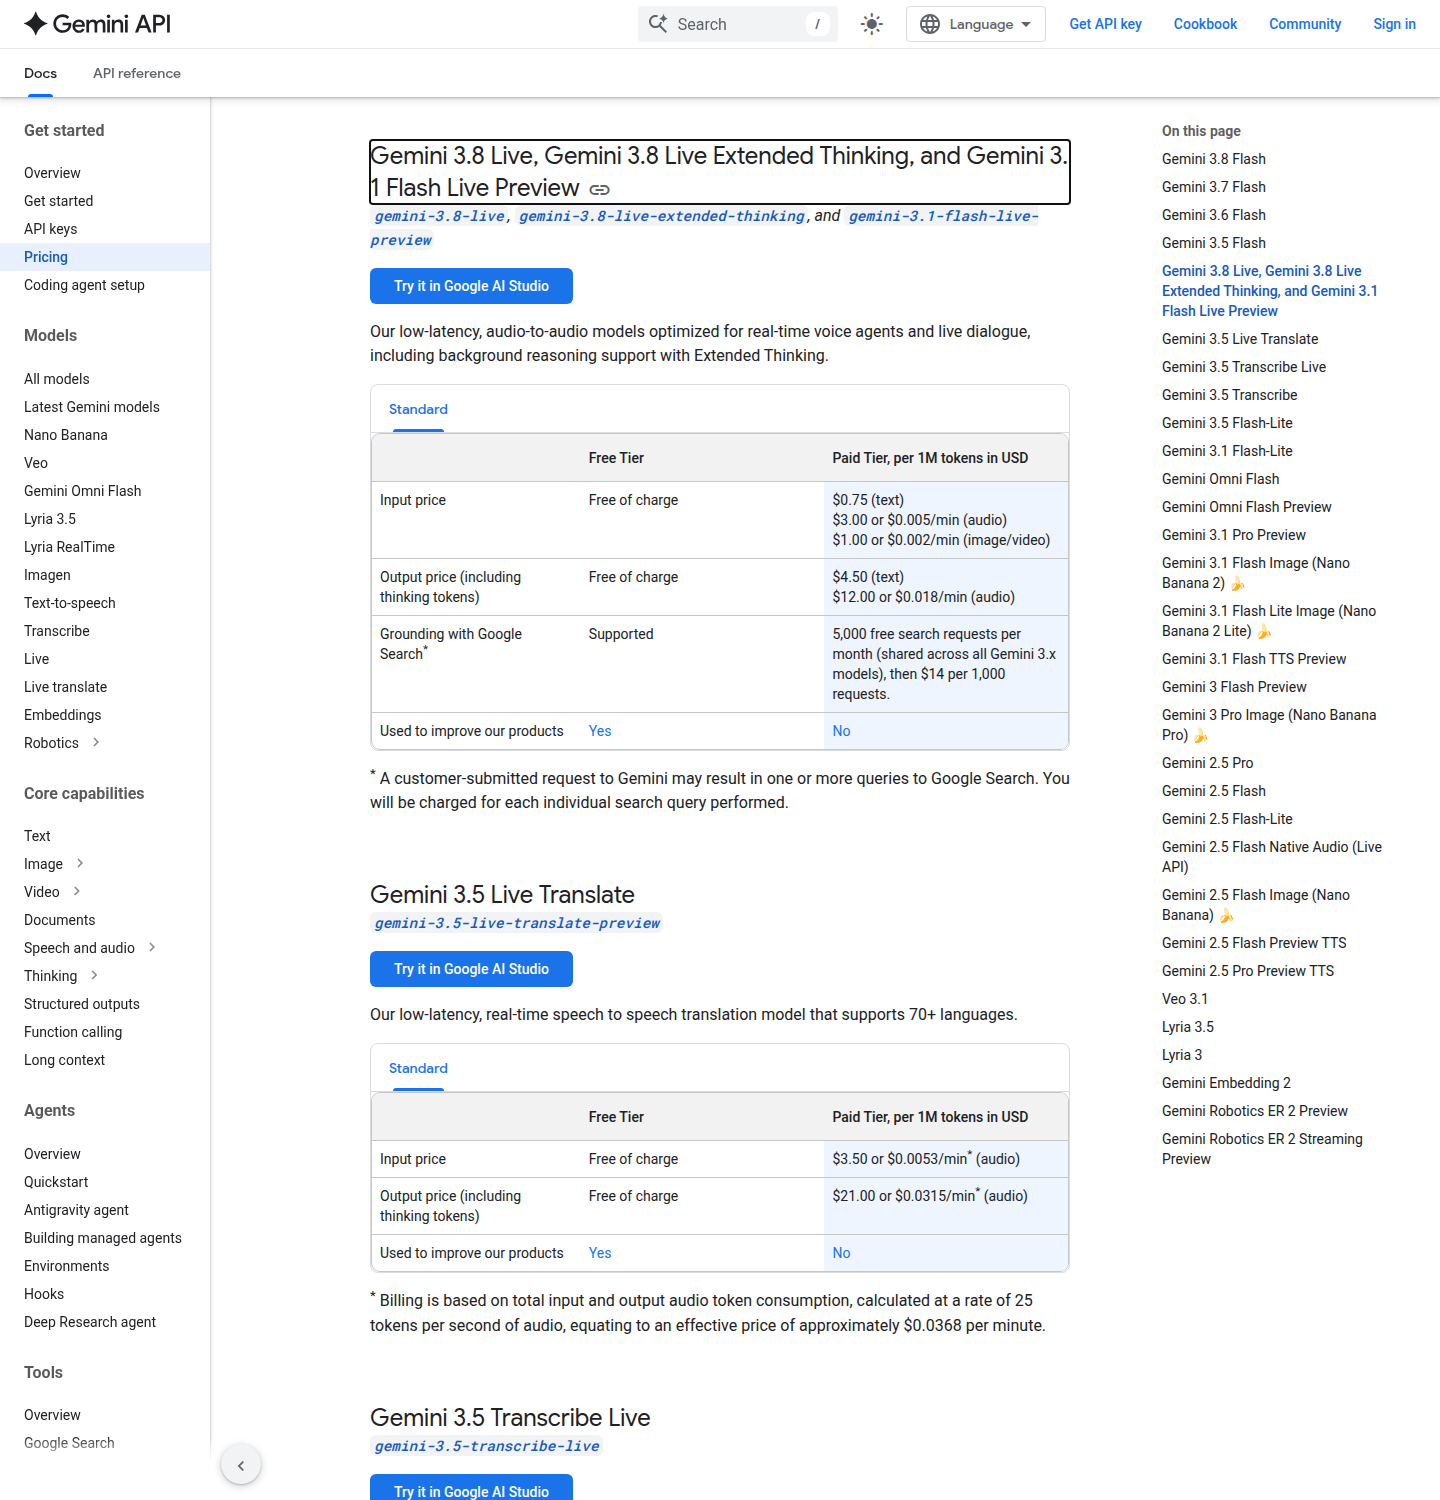
Цены для голосового потока понятные: входящее аудио стоит полцента за минуту, а генерация голоса — меньше двух центов за минуту. Текстовые токены рассуждений тарифицируются по ставке вывода. Для проверки связок есть бесплатный лимит.
Модели поддерживают девяносто семь языков с автопереключением на лету. Можно передавать видеопоток с камеры или экрана. База знаний зафиксирована январём двадцать пятого года, а звук защищён водяным знаком SynthID.