
В Cursor фоновый агент стал расходовать меньше токенов на длинных задачах: разработчики пересобрали обвязку и снизили общую стоимость токенов для пользователей на 7% без падения качества кода. Если раньше агент на каждом шаге тащил громоздкий системный промпт и схемы всех инструментов, то теперь лишнее убрали, а стабильную часть зафиксировали в кэше.
Почему длинная сессия сжигала лишние токены
Когда вы поручаете агенту сложную задачу — переписать модуль или прогнать тесты, — он делает десятки шагов подряд. На каждом шаге модель обращается к серверу заново. Чтобы ассистент помнил задачу, к каждому запросу прикрепляется служебная инструкция.

Раньше эта инструкция постоянно разрасталась. Когда модели были слабее, разработчики страховались длинными запретами: не выводить простыни хешей, не спамить бинарным выводом и символами. Всё это висело мёртвым грузом в контексте.
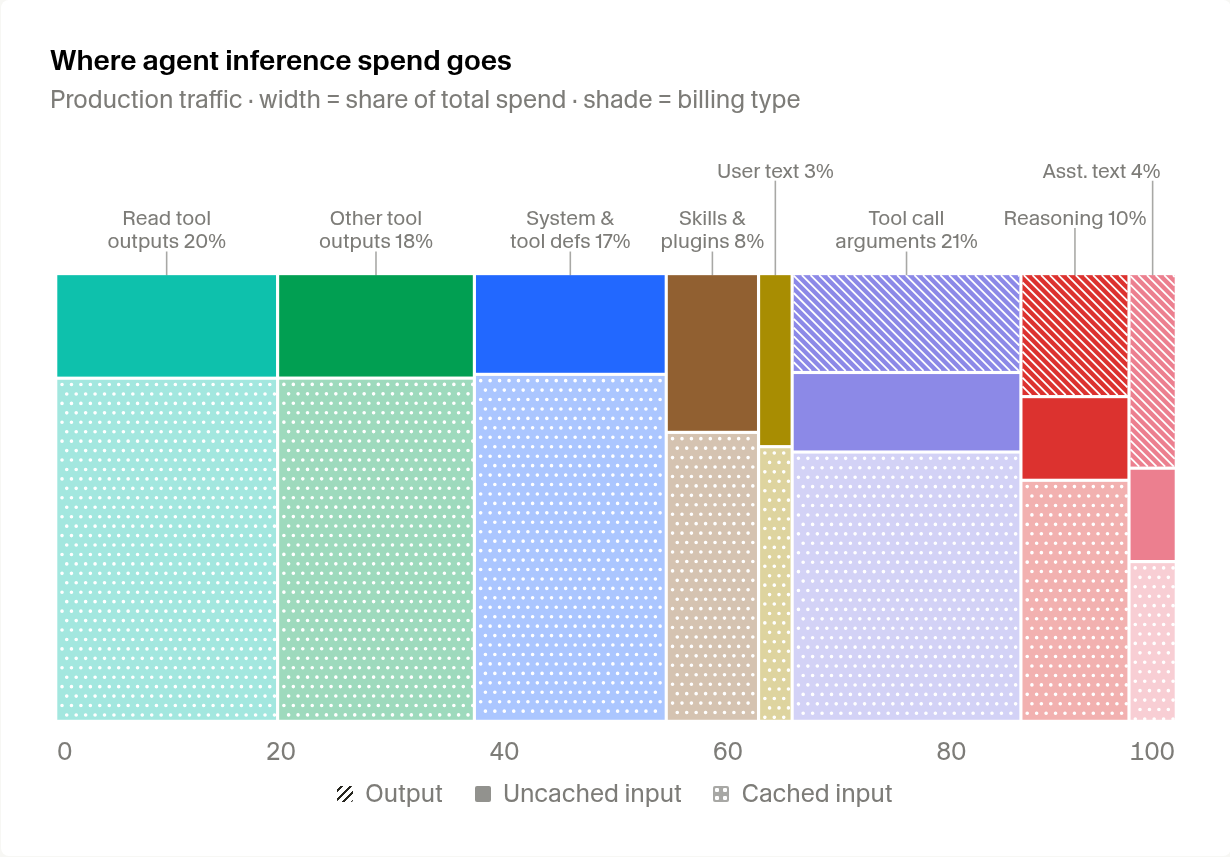
Вместе с правилами передавались и описания всех инструментов: терминала, фоновых процессов, суб-агентов и веб-поиска. Каждому инструменту требуется подробный текст с параметрами вызова.
Если убрать бесконечные запреты из каждого шага, модель не теряет логику, но расходует меньше ресурсов.
В итоге возникал перекос: вы просите поправить строчку, а ассистент отправляет килобайты неизменного текста. Пользователи платили за повтор одного и того же контекста.
Как урезали системный промпт и спрятали редкие инструменты
Инженеры Cursor начали с чистки инструкций. Лишние запреты вычистили, и системный промпт сократился примерно на 66%. Оставили только правила работы с кодом.

Затем пересмотрели встроенные инструменты. Анализ показал, что большинство из них нужны реже чем в 20% диалогов. Зачем передавать их описания при обычной точечной правке?
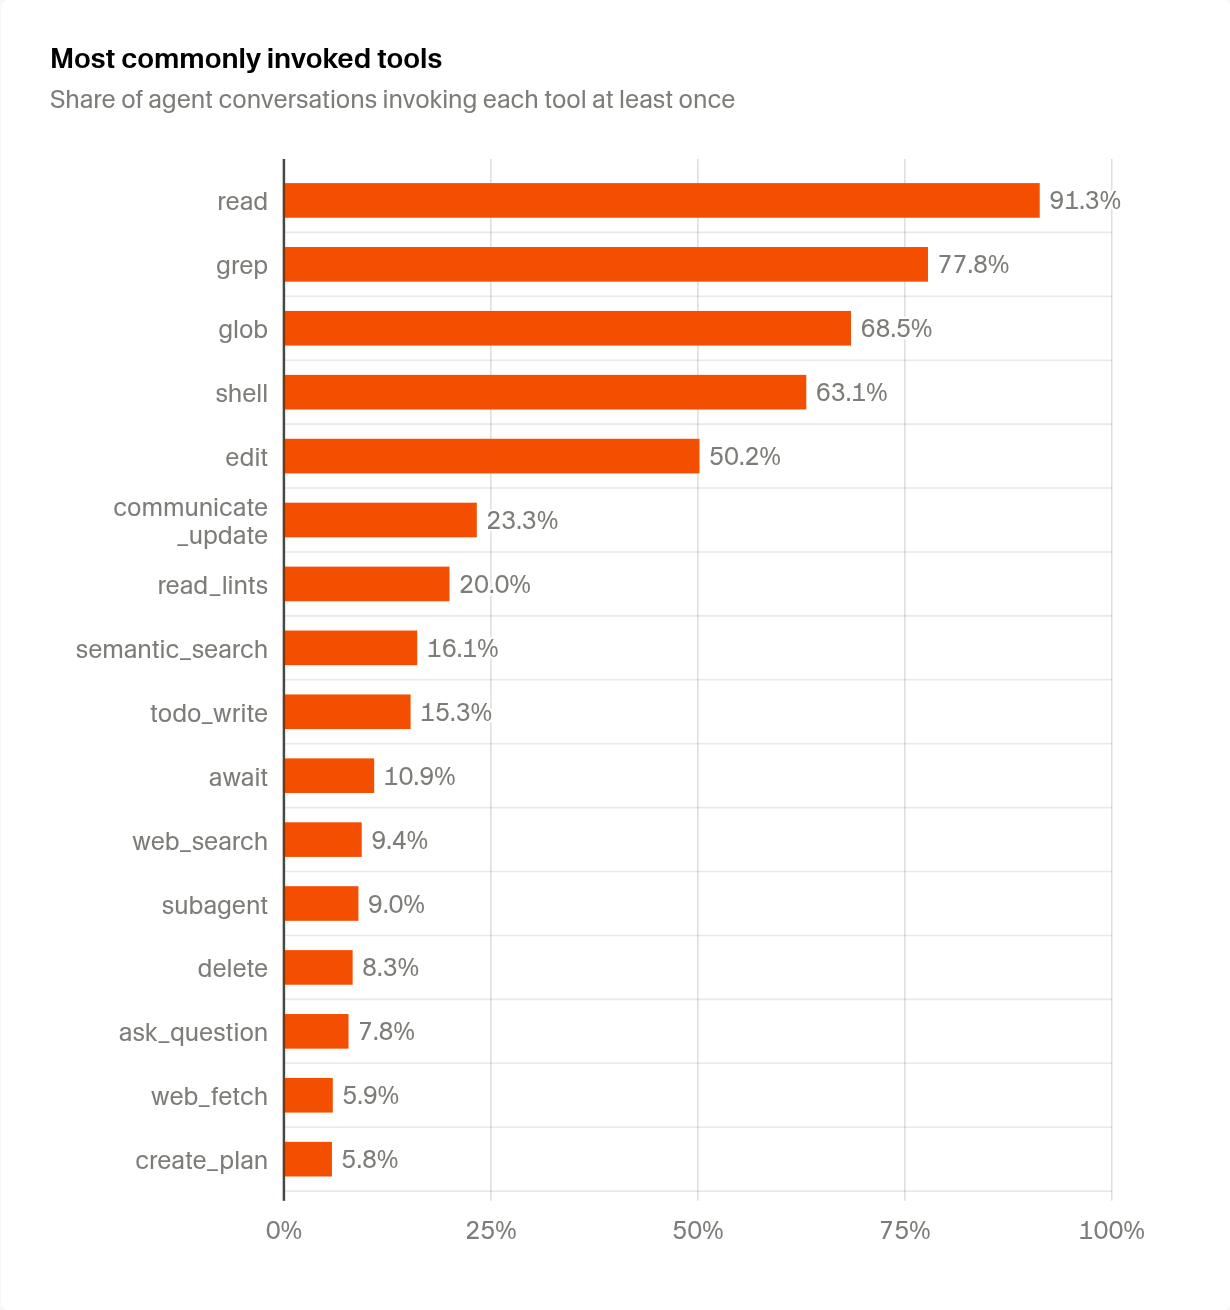
В статическом наборе оставили базу: чтение файлов, поиск по проекту, правку кода и терминал. Сюда же добавили инструмент для вопросов и планировщик. Остальные функции перевели на динамическую загрузку: агент запрашивает полную схему только при реальной необходимости.
Инструменты, которые нужны лишь в каждом пятом диалоге, не должны занимать контекст при каждом шаге.
Этот шаг сократил объём токенов на описание инструментов в статике на 60%. Ранее похожую схему внедрили для серверов MCP, где динамический поиск схем сберёг почти половину токенов в сессиях с внешними инструментами.

Разборы реальных систем автоматизации выходят в нашем сообществе Ковчег в Telegram и на канале Ковчег в MAX, а системно освоить инструменты помогает практическое обучение по Make и искусственному интеллекту.
Где помогли явные границы кэша и нумерация строк
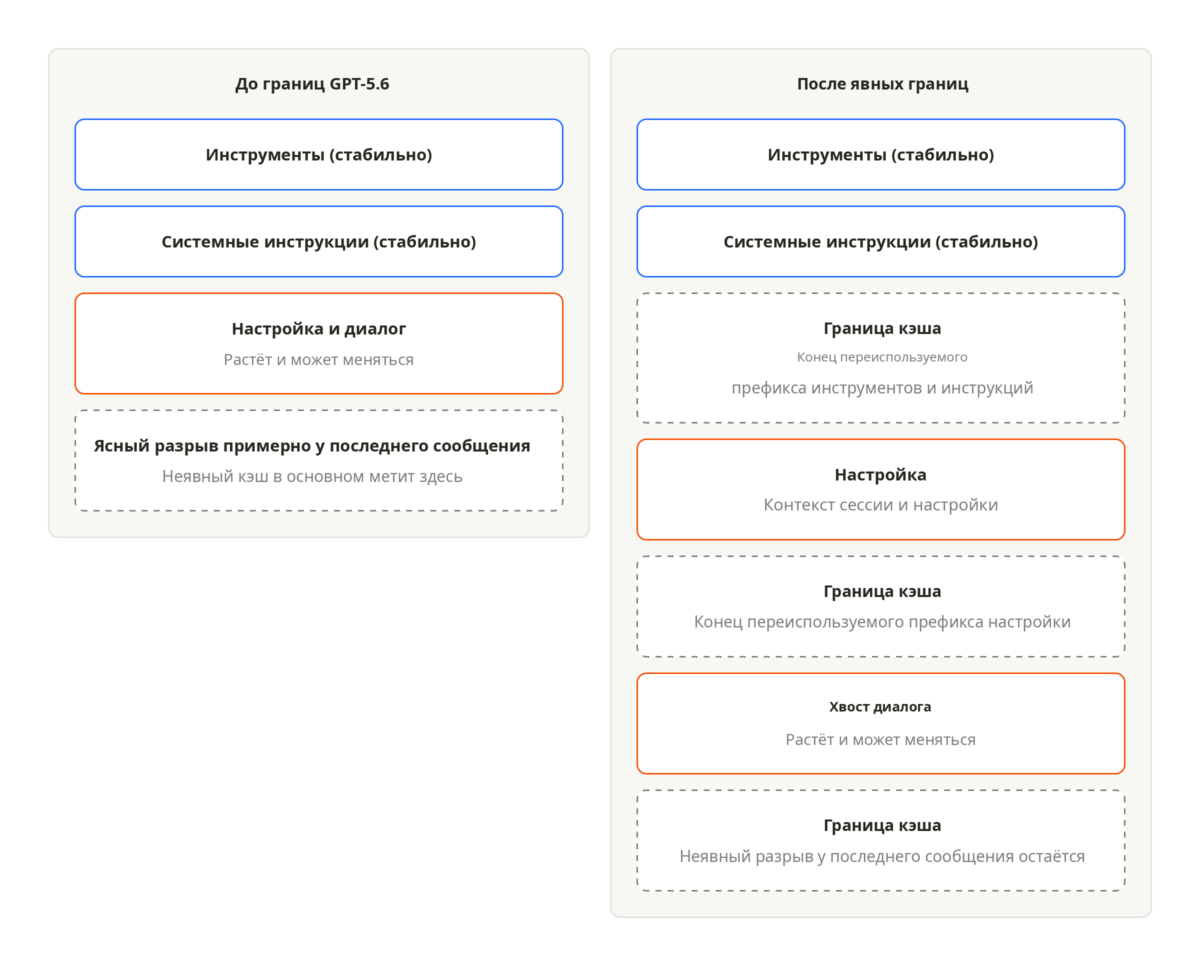
Следующий резерв нашли в кэшировании. При повторных запросах данные из кэша стоят дешевле. Но кэш работает, только когда неизменная часть запроса строго зафиксирована в начале.
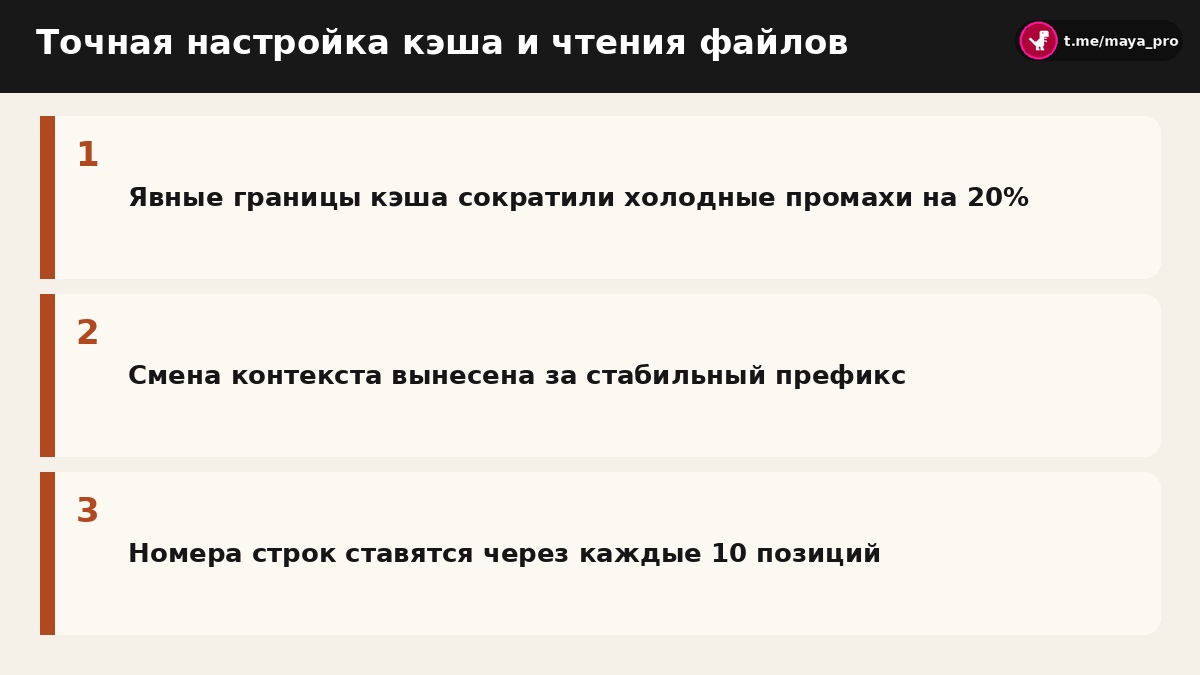
До внедрения API GPT-5.6 граница кэша часто ставилась автоматически возле последнего сообщения. Стабильные инструкции перемешивались с растущей историей диалога. Теперь команда расставила явные точки сохранения: неизменный префикс закреплён намертво, а переменные данные вынесены за границу. В итоге доля холодных промахов кэша упала на 20%.
Ещё одну статью расходов обнаружили в чтении файлов. Инструмент чтения раньше нумеровал каждую строчку, тратя по три-пять токенов на каждую. На десятках тысяч строк это выливалось в заметный объём.
Формат изменили: теперь номера проставляются только у каждой десятой строки. Модели этого достаточно, чтобы точно попадать в цитаты. Это решение срезало 1.6% токенов чтения из кэша.
Реальная экономия строится на деталях — от меток в кэше до шага нумерации строк файла.
Заодно пересмотрели суб-агентов. Из инструкций убрали жёсткое требование изучать проект через вложенных агентов, чтобы избежать дублирования действий.
Что дают эти цифры на практике
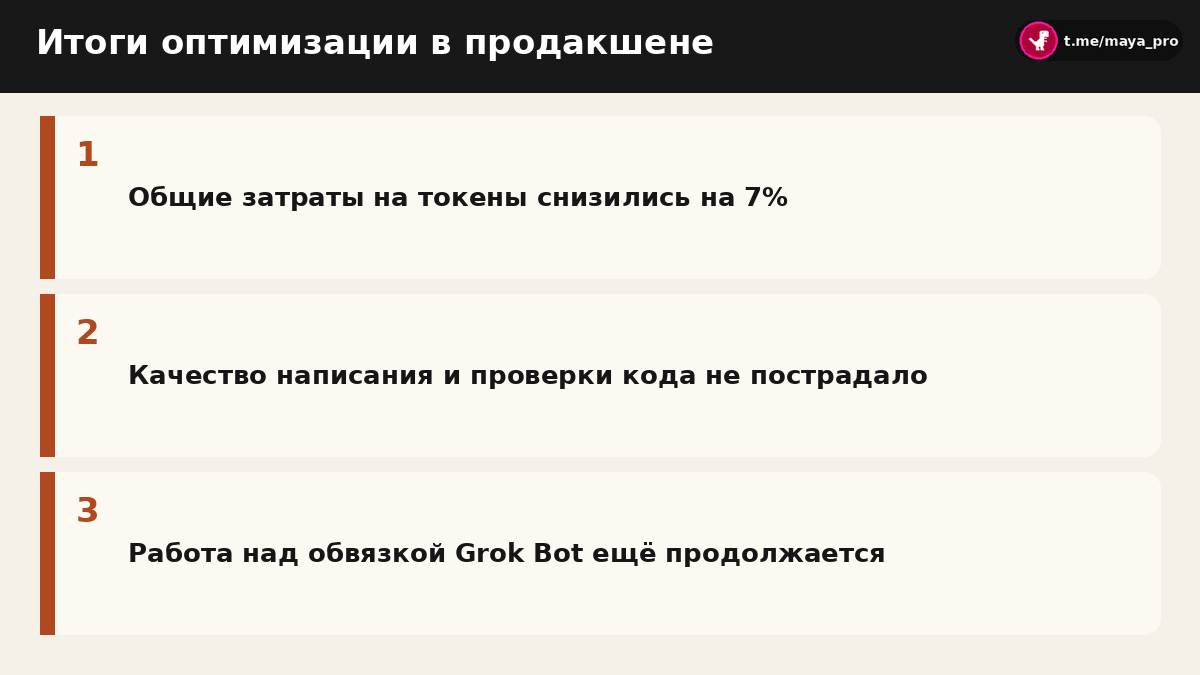
По итогам тестов на реальной нагрузке стоимость токенов у пользователей снизилась на 7%. При этом качество кода и логика работы агента остались на прежнем уровне.
Здесь важно различать метрики и не складывать их между собой:
- 7% экономии на токенах — суммарный результат по всем пользователям на серверах Cursor, а не персональная скидка в тарифе.
- 66% сокращения промпта — урезание служебной инструкции, а не вашей переписки.
- 60% экономии на инструментах — разгрузка статических описаний в запросе.
- 20% меньше промахов кэша — повышение стабильности повторных обращений к модели.
Никаких настроек включать не требуется: изменения уже работают на сервере. Опыт оптимизации сейчас переносят и в обвязку Grok Bot, где работа ещё продолжается.
Для пользователей это значит одно: длинные сессии стали аккуратнее расходовать ресурсы. Чем меньше лишней статики гоняется по кругу, тем быстрее и стабильнее работает агент.